408考点强化-计算机组成原理
前言
本文是 408 计算机组成原理的一轮考点强化笔记,依托 BOK408 计算机组成原理精讲课(25/26 版,24 年录制)整理,按「计算机系统概述 → 数据的表示与运算 → 存储系统 → 指令系统 → 中央处理器 → 总线 → 输入输出系统」七个板块推进。
笔记先从整机组成和性能指标建立全局框架,再依次讨论数据表示、运算部件、存储层次、指令系统和 CPU 执行机制,最后落到总线与输入输出。正文按考点顺序持续推进,后续内容随课程进度继续补充。
- 计算机系统概述:计算机硬件、软件、层次结构、工作原理与性能指标。
- 数据的表示与运算:数制与编码、符号扩展、定点数运算、运算部件、浮点数与 IEEE 754。
- 存储系统:存储器层次、多模块存储器、芯片扩展、Cache、虚拟存储器与外存。
- 指令系统:机器指令、寻址方式、程序机器级表示、CISC 与 RISC。
- 中央处理器:CPU 结构、指令执行、数据通路、微程序、流水线与多处理器。
- 总线:总线的基本概念、分类、性能指标与典型结构。
- 输入输出系统:异常与中断、I/O 接口、程序查询、中断、DMA 等方式。
一、计算机系统概述
这一部分不再按教材逐节展开,而是围绕几个贯穿全章的问题组织:
- 冯·诺依曼机靠什么把指令和数据组织成可执行的程序?
- CPU、主存和 I/O 设备分别负责什么,彼此通过什么连接?
- 一条指令是怎样被取出并执行的?
- 主频、CPI、MIPS 和执行时间之间是什么关系?
这几个问题既对应选择题里的基本概念,也是后面理解存储系统、指令系统和 CPU 的数据通路的基础。
考点1-冯·诺依曼机与“存储程序”
冯·诺依曼计算机由 运算器、控制器、存储器、输入设备和输出设备 五大部分组成。运算器和控制器合称中央处理器 CPU;随着集成电路发展,现代计算机又把运算器、控制器以及寄存器等集中在 CPU 中,但“五大部件”的划分仍然是理解整机结构的基本模型。
冯·诺依曼结构最核心的思想是存储程序:
- 事先把程序以及程序需要处理的数据装入主存;
- 指令和数据都以二进制形式存放;
- CPU 从程序入口开始,按照地址逐条取指令、译码并执行;
- 执行过程中,程序计数器 PC 指示下一条待取指令的位置。
从整机连接关系看,CPU 通过系统总线访问主存和 I/O 接口,外设再经过接口接入系统:
    %%{init: {
  "theme": "base",
  "themeVariables": {
    "primaryColor": "#5b9bd5",
    "primaryTextColor": "#ffffff",
    "primaryBorderColor": "#41719c",
    "lineColor": "#41719c",
    "secondaryColor": "#ffffff",
    "tertiaryColor": "#e2f0d9",
    "fontSize": "16px",
    "fontFamily": "-apple-system, BlinkMacSystemFont, \"Segoe UI\", Roboto, \"Helvetica Neue\", Arial, \"Noto Sans\", sans-serif"
  },
  "flowchart": {
    "nodeSpacing": 8,
    "rankSpacing": 26,
    "curve": "basis",
    "htmlLabels": true,
    "subGraphTitleMargin": { "top": 0, "bottom": 14 },
    "padding": 4,
    "useMaxWidth": false,
    "wrappingWidth": 1000
  }
}}%%
graph LR
  CPU["CPU<br>运算器 / 控制器<br>寄存器"]
  BUS["系统总线<br>地址 / 数据 / 控制"]
  MEM["主存<br>当前程序的<br>指令和数据"]
  IO["I/O 接口<br>数据 / 状态 / 控制"]
  DEV["外部设备"]

  CPU <-->|"访问主存或接口"| BUS
  BUS <--> MEM
  BUS <--> IO
  IO <--> DEV

  classDef root fill:#5b9bd5,stroke:#41719c,color:#ffffff,font-size:20px
  classDef lvl1 fill:#9dc3e6,stroke:#2e6da4,stroke-width:2px,color:#0d2f4d,font-size:19px
  classDef lvl2d fill:#dbe8f6,stroke:#1f4e79,stroke-width:2px,color:#0d2f4d,font-size:16px
  classDef lvl3d fill:#dbe8f6,stroke:#1f4e79,stroke-width:1.5px,color:#0d2f4d,font-size:15px

  class CPU root;
  class BUS lvl1;
  class MEM,IO lvl2d;
  class DEV lvl3d;
从主存里的二进制内容本身看,指令和数据没有天然区别,同一串位模式既可能被解释成指令,也可能被解释成整数、浮点数或地址。真正的区别来自 CPU 当前处于什么阶段、这个地址从哪里来:
- 取指阶段,CPU 把 PC 给出的地址送到存储器,读出的内容作为指令送进指令寄存器 IR;
- 译码阶段,控制器解释 IR 中的操作码,并据此判断这次操作需要哪些操作数;
- 执行阶段,CPU 按指令给出的寻址方式或寄存器内容去访问数据。
例如,二进制序列 0000000000000001 既可能是整数 1,也可能是一条指令的编码。只有放到“取指—译码—执行”的控制过程中,它才获得确定含义。
因此,“指令和数据同等地位存储”强调的是:
- 二者可以存放在同一个存储器中;
- 二者都使用二进制表示;
- 二者都通过相同的存储访问机制读取。
它并不意味着 CPU 无法区分二者。取指时由 PC 和控制器规定访问指令,执行时由指令中的地址字段规定访问数据。哈佛结构则把指令存储器和数据存储器分开,但 408 中讨论的一般仍是冯·诺依曼结构。
程序开始运行前,入口地址被送入 PC。之后循环执行:
- 取指:把 PC 中的地址送入 MAR,主存按地址读出内容并送入 MDR,再把 MDR 中的指令送入 IR;
- 更新 PC:PC 自动加上当前指令的长度,指向下一条指令;
- 译码:控制器分析 IR 中的操作码和地址字段;
- 执行:完成运算、访存、寄存器传送或转移等操作;
- 回到第 1 步,继续取下一条指令。
把取指阶段的寄存器传送写清楚,可以压缩成下面几行:
(PC) → MAR              // PC 给出下一条指令的地址
M(MAR) → MDR            // 主存读出指令
(MDR) → IR              // 当前指令进入指令寄存器
(PC) + 指令长度 → PC     // PC 指向下一条待取指令
这条循环可以表示成:
    %%{init: {
  "theme": "base",
  "themeVariables": {
    "primaryColor": "#5b9bd5",
    "primaryTextColor": "#ffffff",
    "primaryBorderColor": "#41719c",
    "lineColor": "#41719c",
    "secondaryColor": "#ffffff",
    "tertiaryColor": "#e2f0d9",
    "fontSize": "16px",
    "fontFamily": "-apple-system, BlinkMacSystemFont, \"Segoe UI\", Roboto, \"Helvetica Neue\", Arial, \"Noto Sans\", sans-serif"
  },
  "flowchart": {
    "nodeSpacing": 8,
    "rankSpacing": 26,
    "curve": "basis",
    "htmlLabels": true,
    "subGraphTitleMargin": { "top": 0, "bottom": 14 },
    "padding": 4,
    "useMaxWidth": false,
    "wrappingWidth": 1000
  }
}}%%
graph LR
  FETCH["取指<br>PC → MAR → MDR → IR"]
  UPDATE["更新 PC<br>加上指令长度"]
  DECODE["译码<br>分析操作码与地址"]
  EXEC["执行<br>运算 / 访存 / 转移"]
  STOP(["停机或异常"])

  FETCH --> UPDATE
  UPDATE --> DECODE
  DECODE --> EXEC
  EXEC -->|"继续取下一条"| FETCH
  EXEC -->|"结束当前程序"| STOP

  classDef root fill:#5b9bd5,stroke:#41719c,color:#ffffff,font-size:20px
  classDef lvl1 fill:#9dc3e6,stroke:#2e6da4,stroke-width:2px,color:#0d2f4d,font-size:19px
  classDef lvl2d fill:#dbe8f6,stroke:#1f4e79,stroke-width:2px,color:#0d2f4d,font-size:16px
  classDef lvl3d fill:#dbe8f6,stroke:#1f4e79,stroke-width:1.5px,color:#0d2f4d,font-size:15px
  classDef lvl3l fill:#f6fafe,stroke:#c3d9ef,stroke-width:1.5px,color:#0d2f4d,font-size:15px

  class FETCH root;
  class UPDATE lvl1;
  class DECODE lvl2d;
  class EXEC lvl3d;
  class STOP lvl3l;
这里最容易混淆的是 PC 的“加 1”。在原理图或文字描述中经常写成
$$\mathrm{PC}\leftarrow \mathrm{PC}+1$$
但这里的“1”通常是一条指令所占的地址单元数,而不是字节数。若指令定长为 4 字节,主存按字节编址,则取完一条指令后应执行
$$\mathrm{PC}\leftarrow \mathrm{PC}+4$$
若主存按字编址,且一条指令正好占一个存储字,那么地址加 1 就确实表示取下一条指令。所以看到“PC+1”时,要先确认题目默认的编址单位和指令长度。
PC 的自动更新可以由 ALU 中的加法器完成,也可以由专用的 PC 增量器完成。原理上关心的是“PC 指向下一条待取指令”,具体用哪个硬件部件属于数据通路设计问题。转移指令、调用指令和中断响应则会在执行阶段直接改写 PC,因此“自动加 1”不是无条件覆盖 PC,而是取指阶段的默认动作。
自检:PC 到底怎么变化
题目:某机按字节编址,指令长度固定为 4 字节。PC 初值为 0x1000,取出这条指令后 PC 变成多少?
取指阶段要把整条 4 字节指令读走,因此 PC 应加 4:
$$\mathrm{PC}=0x1000+4=0x1004$$
若指令长度为 2 字节,则执行 PC←PC+2。只有在“按字编址且一条指令恰好占一个字”时,符号写法 PC←PC+1 才直接对应下一条指令。
记忆:PC 中存放的是下一条指令的地址,不是下一条数据的地址。操作数地址一般来自指令的地址字段、寄存器内容或寻址方式计算。
考点2-CPU、主存、I/O 与总线
408 题经常根据功能倒推寄存器名称,因此不能只记缩写:
| 部件 | 主要作用 | 易错点 |
|---|---|---|
| PC | 保存下一条待取指令的地址 | 它指向指令,执行阶段可能被转移类指令改写 |
| IR | 保存当前正在译码、执行的指令 | 保存整条指令,不只是操作码 |
| MAR | 保存本次要访问的存储单元地址 | MAR 位数决定可寻址空间,不直接决定存储器总容量 |
| MDR | 保存与主存交换的数据或指令 | 又称 MBR,位数常与存储字长或数据总线宽度有关 |
| 通用寄存器 | 暂存操作数、中间结果、地址 | 程序员通常可见,由指令直接使用 |
| PSW | 保存标志位、中断允许位、运行状态等 | 其中条件码可能决定条件转移 |
| ALU | 完成算术运算和逻辑运算 | ALU 本身不存放指令,也不单独决定执行顺序 |
| 控制器 | 对指令译码并产生控制信号 | 微程序控制器还会访问控制存储器 |
CPU 与主存之间一次典型的信息传递可以写成:
CPU 内部地址 → MAR → 主存
主存数据     → MDR → CPU 内部寄存器
PC 指向指令,IR 保存当前指令,MAR 送地址,MDR 接数据,四者不能因为都与“访存”有关而混用。
“主存”指 CPU 能直接按地址访问、用于存放当前运行程序和数据的那一层存储器。完整存储层次通常可以概括为:
- 寄存器:位于 CPU 内,速度最快、容量最小;
- Cache:位于 CPU 内或紧邻 CPU,对程序员透明,缓存主存中的活跃数据;
- 主存:存放当前要执行的指令和数据;
- 外存:如磁盘、SSD,容量大、价格低,但 CPU 不能直接执行其中的指令,程序和数据必须先调入主存。
    %%{init: {
  "theme": "base",
  "themeVariables": {
    "primaryColor": "#5b9bd5",
    "primaryTextColor": "#ffffff",
    "primaryBorderColor": "#41719c",
    "lineColor": "#41719c",
    "secondaryColor": "#ffffff",
    "tertiaryColor": "#e2f0d9",
    "fontSize": "16px",
    "fontFamily": "-apple-system, BlinkMacSystemFont, \"Segoe UI\", Roboto, \"Helvetica Neue\", Arial, \"Noto Sans\", sans-serif"
  },
  "flowchart": {
    "nodeSpacing": 8,
    "rankSpacing": 26,
    "curve": "basis",
    "htmlLabels": true,
    "subGraphTitleMargin": { "top": 0, "bottom": 14 },
    "padding": 4,
    "useMaxWidth": false,
    "wrappingWidth": 1000
  }
}}%%
graph LR
  REG["寄存器<br>最快 / 最小<br>位于 CPU 内"]
  CACHE["Cache<br>硬件自动管理<br>缓存活跃数据"]
  MAIN["主存<br>按地址直接访问<br>存放当前程序"]
  DISK["外存<br>容量最大<br>持久保存"]

  REG --> CACHE
  CACHE --> MAIN
  MAIN --> DISK

  classDef root fill:#5b9bd5,stroke:#41719c,color:#ffffff,font-size:20px
  classDef lvl1 fill:#9dc3e6,stroke:#2e6da4,stroke-width:2px,color:#0d2f4d,font-size:19px
  classDef lvl2d fill:#dbe8f6,stroke:#1f4e79,stroke-width:2px,color:#0d2f4d,font-size:16px
  classDef lvl3d fill:#dbe8f6,stroke:#1f4e79,stroke-width:1.5px,color:#0d2f4d,font-size:15px

  class REG root;
  class CACHE lvl1;
  class MAIN lvl2d;
  class DISK lvl3d;
上图展示的是完整存储层次,主存只是其中一层。寄存器也不全相同:既有指令可直接访问的通用寄存器,也有 PC、IR、MAR、MDR 这类专用寄存器。Cache 虽由高速存储单元构成,但逻辑上处于 CPU 与主存之间。
CPU 通常不能直接驱动键盘、磁盘等设备,中间需要 I/O 接口完成地址译码、数据缓冲、状态保存和格式转换。接口中常见三类寄存器:
- 数据寄存器:暂存取入或送出的数据;
- 状态寄存器:保存忙、就绪、错误等状态;
- 控制寄存器:接收 CPU 发出的启动、读写模式等命令。
I/O 的主要控制方式包括程序查询、中断和 DMA。前两种通常仍由 CPU 参与数据传送,DMA 则让 DMA 控制器在设备与主存之间成批搬运数据,CPU 主要负责启动和收尾。
总线是一组能为多个部件共享的信息传输线。按所传信息可分为:
- 数据总线:传送数据、指令和状态信息,宽度影响一次能传多少位;
- 地址总线:传送存储单元或 I/O 端口地址,宽度决定可寻址范围;
- 控制总线:传送读/写命令、中断请求、总线请求、时钟和应答等控制信号。
存储器和 I/O 设备都通过总线或相应的接口连接 CPU。现代计算机常采用多级总线结构,但无论结构怎样变化,“地址指出找谁,数据完成传输,控制信号规定何时做什么”这三类信息始终存在。
记忆:地址线决定“找哪里”,数据线负责“送什么”,控制线规定“何时、怎么做”。
考点3-按字节编址、按字编址与存储字长
这部分是系统概述与存储系统之间的连接点,也是后续计算主存容量、Cache 地址划分和指令地址的基础。
- 按字节编址:每个地址对应 1 字节,地址加 1 表示移动到下一字节;
- 按字编址:每个地址对应 1 个存储字,地址加 1 表示移动到下一个存储字;
- 若一个存储字长 32 位,则每个存储字占 4 个字节。
| 编址方式 | 一个地址代表的数据 | 地址加 1 的含义 | 32 位地址的最大容量 |
|---|---|---|---|
| 按字节编址 | 1 字节 | 移动到下一字节 | $2^{32}\,\mathrm{B}=4\,\mathrm{GB}$ |
| 按 32 位字编址 | 32 位,即 4 字节 | 移动到下一存储字 | $2^{32}\times4\,\mathrm{B}=16\,\mathrm{GB}$ |
因此,“按字节编址且存储字长为 32 位”时,一个存储字会占用连续的 4 个字节地址。若某存储字从地址 A 开始,它的四个字节分别位于 A、A+1、A+2、A+3;下一条存储字从 A+4 开始。
存储字长是一个存储单元中实际存放的二进制位数,常见为 8、16、32 或 64 位。它不一定等于:
- 指令字长:机器指令的位数;
- 数据字长:CPU 一次处理的数据位数;
- 数据总线宽度:一次总线传输的位数。
三者可能相同,也可能通过多次访存或总线传输完成匹配。例如存储字长为 32 位、数据总线宽度为 16 位时,一次读出或写入一个完整存储字可能需要两个总线传送周期。
先看一个地址对应多少数据,再数一共有多少个地址,最后相乘。不要看到 MAR 有 $n$ 位就直接写容量为 $2^n$ 字节。
若设 MAR 位数为 $n$,按字节编址,则最多有 $2^n$ 个字节地址,主存最大容量为
$$\text{容量}=2^n\,\mathrm{B}$$
如果按字编址、每个存储字为 $w$ 位,则
$$\text{容量}=2^n\times w\quad(\mathrm{bit})$$
例如 32 位地址、按字节编址时,地址空间上限是
$$2^{32}\,\mathrm{B}=4\,\mathrm{GB}$$
若同一机器改成“32 位地址、按 32 位字编址”,则可寻址 $2^{32}$ 个字,最大容量相当于 16 GB。地址位数没变,但每个地址所代表的数据量变了。
自检:编址单位改变后,容量变不变?
设地址线为 24 位:
- 按字节编址:共有 $2^{24}$ 个字节地址,容量为
$$2^{24}\,\mathrm{B}=16\,\mathrm{MB}$$
- 若按 16 位字编址:每个地址对应 2 字节,容量变为
$$2^{24}\times2\,\mathrm{B}=32\,\mathrm{MB}$$
地址位数完全没变,只是“一个地址代表多少数据”变了。题目若同时给出 MAR 位数和编址方式,必须按后者修正。
MAR 有 32 位并不自动等于存储容量 4 GB。必须先看编址单位;若按字编址且字长为 32 位,容量还要乘每个字的字节数。
考点4-主频、CPI、CPU时间与MIPS
主频 $f$ 表示 CPU 每秒钟产生多少个时钟周期,时钟周期 $T_c$ 是它的倒数:
$$T_c=\frac{1}{f}$$
例如主频为 $2\,\mathrm{GHz}$,则
$$T_c=\frac{1}{2\times10^9}=0.5\,\mathrm{ns}$$
频率使用十进制单位:$1\,\mathrm{kHz}=10^3\,\mathrm{Hz}$,$1\,\mathrm{MHz}=10^6\,\mathrm{Hz}$,$1\,\mathrm{GHz}=10^9\,\mathrm{Hz}$。存储容量中的 K、M、G 则经常使用 $2^{10}$、$2^{20}$、$2^{30}$,两类单位不要混用。
CPI 是 clock cycles per instruction,即平均执行一条指令所需的时钟周期数。若程序共执行 $N$ 条指令,平均 CPI 为 $\overline{\mathrm{CPI}}$,则总时钟周期数和执行时间分别为
$$C=N\times\overline{\mathrm{CPI}}$$
$$T_{\mathrm{CPU}}=N\times\overline{\mathrm{CPI}}\times T_c =\frac{N\times\overline{\mathrm{CPI}}}{f}$$
可以把这套关系压缩成一条“性能链”:
指令条数 × 平均 CPI = 所需时钟周期数
时钟周期数 × 时钟周期 = CPU 执行时间

CPU 时间 = N × CPI × Tc
         = N × CPI / f
不同指令的 CPI 可能不同,因此平均 CPI 必须按各类指令的条数加权:
$$\overline{\mathrm{CPI}} =\frac{\sum_i (N_i\times\mathrm{CPI}_i)}{N}$$
例如一个程序执行 10 亿条指令,平均 CPI 为 2.5,主频为 2 GHz,则
$$T_{\mathrm{CPU}} =10^9\times2.5\times\frac{1}{2\times10^9} =1.25\,\mathrm{s}$$
若只提高主频,但 CPI 因流水线加深、访存等待等原因上升,执行时间不一定下降。考试中比较“优化前后”,必须重新把指令条数、CPI 和主频三项一起代入。
MIPS 表示每秒执行多少百万条指令,即
$$\mathrm{MIPS} =\frac{\text{指令条数}}{\text{执行时间}\times10^6}$$
展开:从执行时间到 MIPS 的完整推导
把前面 CPU 时间公式 $T_{\mathrm{CPU}}=N\times\overline{\mathrm{CPI}}/f$ 代入:
$$\mathrm{MIPS} =\frac{N}{\dfrac{N\times\overline{\mathrm{CPI}}}{f}\times10^6} =\frac{f}{\overline{\mathrm{CPI}}\times10^6}$$
也可以先求每秒指令数 IPS:
$$\mathrm{IPS} =\frac{1}{T_{\mathrm{CPU}}/N} =\frac{f}{\overline{\mathrm{CPI}}}$$
再除以 $10^6$ 得到 MIPS。注意 $f$ 要使用 Hz,而不是 MHz 或 GHz;若 $f$ 取 GHz,则分母中的 $10^6$ 要相应换成 $10^3$。
以上式为例,2 GHz 主频、平均 CPI 为 2.5 时:
$$\mathrm{MIPS} =\frac{2\times10^9}{2.5\times10^6} =800$$
反过来,若已知 MIPS 和指令条数 $N$,程序执行时间为
$$T=\frac{N}{\mathrm{MIPS}\times10^6}$$
两台机器的指令集不同,完成同一个任务所需的指令条数可能相差很多;同一条高级语言语句也可能编译成不同数量的机器指令。因此 MIPS 只能在指令集、编译器以及程序特征大致相同时作粗略参考,比较计算机性能的核心指标仍是 完成同一任务所需的执行时间。
主频提高只缩短了 $T_c$。如果优化导致程序指令数增加,或流水线加深、访存等待使平均 CPI 上升,最终执行时间仍可能变长。比较性能时必须把三个量一起代入。
若题目讨论流水线、访存缺失、Cache 等情况,所谓实际 CPI 还应包含这些停顿周期。可以把总周期拆为
$$C=N\times\mathrm{CPI}_{\text{ideal}}+ \text{停顿周期}$$
再用总周期乘时钟周期求执行时间。这一思路会在 CPU 流水线部分继续使用。
本部分常见易错点
例如“指令和数据完全无法区分”“主频越高运行越快”“MIPS 越大机器性能一定越强”,这些说法都忽略了控制过程和应用条件。
| 易混内容 | 正确理解 |
|---|---|
| 指令和数据是否“完全无法区分” | 二进制形式相同,但按 PC 取指还是按地址取操作数,由控制过程和地址来源决定 |
| PC 是否指向数据 | PC 通常指向下一条指令;操作数地址来自指令或寄存器 |
| PC+1 是否一定是加 1 字节 | 取决于编址单位和指令长度,原理图中的“1”常表示一条指令或一个存储字 |
| MAR 位数是否直接等于容量 | 还要看编址单位和每个地址对应的数据宽度 |
| 存储字长是否等于指令字长 | 可以不同,要通过多次访存等方式匹配 |
| 主频越高是否一定越快 | 还要看总指令数和 CPI,不能单独比较主频 |
| MIPS 是否可跨机器绝对比较 | 不适合跨指令集直接比较,只反映单位时间执行的指令条数 |
一分钟复盘:四个必须能脱口而出的结论
- 存储程序:程序和数据先放入主存,CPU 按 PC 逐条取指执行。
- 指令与数据:位模式本身无标签,由取指/执行阶段和地址来源决定解释方式。
- 存储容量:地址数 × 每个地址对应的数据宽度,不能只看 MAR 位数。
- 执行时间:$T_{\mathrm{CPU}}=N\times\mathrm{CPI}\times T_c$;MIPS 只是间接指标。
二、数值的表示与运算
考点1-进位计数制及其转换
数值表示题最常见的错误,不是不会算,而是把不同层次的概念混在一起比较。先看一个总框架:
- 按“有没有符号”先分成无符号数和有符号数;
- 无符号数直接按二进制位权解释,常用于地址、计数和边界检查;
- 有符号数才需要进一步指定原码、反码、补码或移码;
- 同一个位模式在不同编码下可能得到完全不同的真值。
因此,“原码”和“无符号数”并不是同一层的分类:无符号数是一类解释方式,原码是带符号数的一种具体编码。
    %%{init: {
  "theme": "base",
  "themeVariables": {
    "primaryColor": "#5b9bd5",
    "primaryTextColor": "#ffffff",
    "primaryBorderColor": "#41719c",
    "lineColor": "#41719c",
    "secondaryColor": "#ffffff",
    "tertiaryColor": "#e2f0d9",
    "fontSize": "16px",
    "fontFamily": "-apple-system, BlinkMacSystemFont, \"Segoe UI\", Roboto, \"Helvetica Neue\", Arial, \"Noto Sans\", sans-serif"
  },
  "flowchart": {
    "nodeSpacing": 8,
    "rankSpacing": 26,
    "curve": "basis",
    "htmlLabels": true,
    "subGraphTitleMargin": { "top": 0, "bottom": 14 },
    "padding": 4,
    "useMaxWidth": false,
    "wrappingWidth": 1000
  }
}}%%
graph TB
  ROOT["数值表示"]
  UNSIGNED["无符号数<br>直接按位权解释<br>常用于地址运算"]
  SIGNED["有符号数<br>先确定编码方式<br>再还原真值"]
  YUAN["原码"]
  FAN["反码"]
  BU["补码"]
  YI["移码"]

  ROOT --> UNSIGNED
  ROOT --> SIGNED
  SIGNED --> YUAN
  SIGNED --> FAN
  SIGNED --> BU
  SIGNED --> YI

  classDef root fill:#5b9bd5,stroke:#41719c,color:#ffffff,font-size:20px
  classDef lvl1 fill:#9dc3e6,stroke:#2e6da4,stroke-width:2px,color:#0d2f4d,font-size:19px
  classDef lvl2d fill:#dbe8f6,stroke:#1f4e79,stroke-width:2px,color:#0d2f4d,font-size:16px

  class ROOT root;
  class UNSIGNED,SIGNED lvl1;
  class YUAN,FAN,BU,YI lvl2d;
机器数是在机器中实际存放的固定位宽位模式,真值是这个位模式按照某种编码解释后得到的数学意义上的数。
两个概念不能用“二进制/十进制”来区分:
- 机器数除了写成二进制,也常写成十六进制或一串位;
- 真值不一定写成十进制,也可以写成 $+1100_2$、$-101_2$;
- 真值的标志是用 $+$、$-$ 表示正负,而机器数用最高位等规则编码符号。
同一个 4 位机器数 1100 可以表示:
| 解释方式 | 真值 | 计算过程 |
|---|---|---|
| 无符号数 | $12$ | $8+4$ |
| 原码 | $-4$ | 符号位为 1,数值位 100 表示 4 |
| 反码 | $-3$ | 负数反码的数值位取反得 100,表示 3 |
| 补码 | $-4$ | $-2^3+2^2=-8+4$ |
| 4 位移码(偏置 8) | $4$ | 无符号值 $12-8=4$ |
所以,单说“1100 等于多少”是不完整的。必须先问:它按无符号数还是某种有符号编码解释?位宽是多少?
注:真值
+1100与 4 位机器数1100看起来字符相同,但前者已经把正号单独写出来,是一个带符号真值;后者仍只是一个需要指定编码才能解释的位模式。
无符号数没有符号位,所有位都按权值相加:
$$V=\sum_{i=0}^{n-1}b_i2^i$$
例如 8 位无符号数 10110100:
$$V=128+32+16+4=180$$
无符号数的 $n$ 位表示范围是
$$0\sim 2^n-1$$
地址通常是非负整数,而且要覆盖整个地址空间,因此常按无符号数处理。例如比较两个地址大小时使用无符号比较;若误把它们当成有符号补码,地址最高位为 1 时就会被判成负数。
原码的规则最直接:最高位表示符号,其余位直接表示绝对值。
- 正数:符号位为 0,数值位就是真值的二进制;
- 负数:符号位为 1,数值位仍写绝对值的二进制;
- 由原码求真值:去掉符号位,把数值位直接转成十进制,再加上符号。
例如:
$$[+5]_{\text{原}}=0101 \qquad [-5]_{\text{原}}=1101$$
原码的优点是符号和绝对值一目了然,缺点是加法和减法不能直接统一成补码加法,而且零有两种表示:
$$[+0]_{\text{原}}=0000 \qquad [-0]_{\text{原}}=1000$$
反码由原码得到:
- 正数的反码与原码相同;
- 负数保持符号位不变,数值位逐位取反;
- 由负数反码求真值时,把数值位再取反得到绝对值的二进制。
例如:
$$[-5]_{\text{原}}=1101 \qquad [-5]_{\text{反}}=1010$$
反码同样有正零和负零,实际运算中主要用于理解它与补码之间的关系。
补码是现代计算机中最常用的定点整数编码。正数补码与原码相同;负数补码可由原码“数值位取反再加 1”得到,也可以由反码末位加 1 得到。
更统一的理解是最高位带负权。对于 $n$ 位补码 $b_{n-1}\cdots b_1b_0$:
$$V=-b_{n-1}2^{n-1}+\sum_{i=0}^{n-2}b_i2^i$$
例如:
$$1100_{\text{补}} =-2^3+2^2 =-8+4 =-4$$
最高位为 1 时,先写下最高位的负权值,再把其余位按普通无符号数相加。比如
$$11101010_{\text{补}}=-128+64+32+8+2=-22$$
这比“先取反、再加 1、再按无符号数读”更不容易丢步骤。
补码求相反数也很方便:把补码连同符号位一起逐位取反,再在末位加 1:
$$[-X]_{\text{补}}=\sim[X]_{\text{补}}+1$$
所以两个补码相减可以直接改成“加相反数”:
$$[X-Y]_{\text{补}}=[X]_{\text{补}}+[-Y]_{\text{补}}$$
这正是补码适合统一实现加减法的原因。
符号扩展不会改变真值。 把较短补码放入更宽寄存器时:
- 正数高位补 0;
- 负数高位补 1;
- 扩展前后补码表示的真值完全相同。
例如 4 位补码 1100 表示 $-4$,扩展到 8 位后是
$$11111100_{\text{补}}=-128+64+32+16+8+4=-4$$
反过来说,一个很长的补码如果高位有大量重复的符号位,可以化简为能保持真值的最短补码:
$$111111111100_{\text{补}} \rightarrow 1100_{\text{补}}=-4$$
自检:长补码化简后为什么值不变?
短补码 1100 表示 $-4$。每次把它符号扩展到左边一位,相当于新增一个权值为 $+2^k$ 的位,同时原来负权最高位从 $-2^k$ 变成更高一层的负权:
$$-2^{k+1}+2^k=-2^k$$
新增的 1 与符号扩展造成的权值变化恰好抵消,所以真值不变。
这就是“连续相同的符号位可以删到最短”的原因,但最低有效位和符号位不能随意删。
移码通常用“真值 + 偏置”得到编码:
$$[X]_{\text{移}}=X+\text{偏置}$$
对普通 $n$ 位整数移码,常用偏置是
$$2^{n-1}$$
例如 4 位移码的偏置为 8:
| 真值 | 移码 |
|---|---|
| $-8$ | 0000 |
| $0$ | 1000 |
| $7$ | 1111 |
把移码当无符号数看,其大小顺序与真值顺序一致,因此浮点数常用来表示阶码,便于直接比较大小。
同一真值的移码与补码相比,符号位相反,数值位相同。例如 4 位补码与移码:
| 真值 | 补码 | 移码 |
|---|---|---|
| $-4$ | 1100 |
0100 |
| $0$ | 0000 |
1000 |
| $3$ | 0011 |
1011 |
普通 $n$ 位整数移码的偏置是 $2^{n-1}$。
IEEE 754 的阶码字段有 $k$ 位时,偏置是
$$2^{k-1}-1$$
例如单精度阶码有 8 位,偏置是 127,而不是 128。IEEE 754 还需要把全 0 和全 1 阶码留给零、非规格化数、无穷大和 NaN,因此规格化数的阶码字段只用 $1\sim254$,对应实际指数 $-126\sim127$。
设机器字长为 $n$,并把这些编码按定点整数理解,则固定位数真值的上下限为:
| 编码 | $n$ 位真值范围 | 8 位范围 | 零的表示 |
|---|---|---|---|
| 无符号数 | $0\sim2^n-1$ | $0\sim255$ | 唯一 |
| 原码 | $-(2^{n-1}-1)\sim2^{n-1}-1$ | $-127\sim127$ | 正零、负零 |
| 反码 | $-(2^{n-1}-1)\sim2^{n-1}-1$ | $-127\sim127$ | 正零、负零 |
| 补码 | $-2^{n-1}\sim2^{n-1}-1$ | $-128\sim127$ | 唯一 |
| 移码 | $-2^{n-1}\sim2^{n-1}-1$ | $-128\sim127$ | 唯一 |
补码比原码、反码多表示一个负数,是因为 1000...0 不再浪费在负零上,而被规定为 $-2^{n-1}$。
自检:说明 4 位补码 `1000` 为什么表示 $-8$ 而不是 $-0$
按最高位负权计算:
$$1000_{\text{补}}=-2^3=-8$$
如果按“符号位 + 绝对值”理解,就会误以为它是负零。原码、反码和补码必须使用各自的解释规则,不能把原码规则套到补码上。
同理,8 位补码的表示范围是 $-128\sim127$;10000000 表示 $-128$,它的模 8 位相反数仍然是自身。
如果题目表示的是定点小数,而不是整数,则范围随隐含小数点位置缩放。若低 $k$ 位是小数位,实际真值要整体乘 $2^{-k}$,表示间隔和范围也同步缩放。
移位的题目要先问两个问题:操作对象是哪一个位模式,右移时高位该补什么。
对于补码:
- 算术左移:低位补 0,高位直接移出;
- 算术右移:高位补原来的符号位;
- 逻辑右移:高位一律补 0,不保留符号。
逻辑左移也是低位补 0、高位移出,但“逻辑”与“算术”的差别主要体现在右移:逻辑右移把整个位模式看成一串二进制位,算术右移则把最高位解释成负权。
补码 1101    算术右移 1 位 → 1110
             (-3)          (-2)

补码 1101    逻辑右移 1 位 → 0110
           (若按无符号看)   (13 → 6)
算术右移相当于对补码做“除以 2 后向负无穷取整”。所以负数右移时可能看起来只变了 1:
$$-3\gg 1=-2$$
逻辑移位通常用于无符号数,算术移位用于补码。若把负数补码直接做逻辑右移,符号位会被清成 0,真值语义随即被破坏。
左移 1 位时,可以直接观察移位前后的符号位:
- 符号位没有改变,通常没有有符号溢出;
- 符号位改变,发生有符号溢出。
例如 4 位补码中:
$$0101_2=5 \quad\xrightarrow{\text{算术左移 1 位}}\quad 1010_2=-6$$
从正数移成了负数,说明 $5\times2=10$ 已超出 4 位补码范围,发生溢出。若结果是 $1100\rightarrow1000$,二者仍都是负数;$-4\times2=-8$ 恰好在 4 位补码范围内,所以不溢出。
左移相当于乘 2,右移相当于除 2 的幂;但只有在目标结果仍能由当前位宽表示时,移位后的位模式和数学结果才一致。
考点2-补码加减运算与加法器
补码加减法的核心是:减法先改成加相反数,剩下的全部交给加法器。
$$X-Y=X+\overline{Y}+1$$
下面这张图把“加法”和“减法”统一到了同一套硬件:
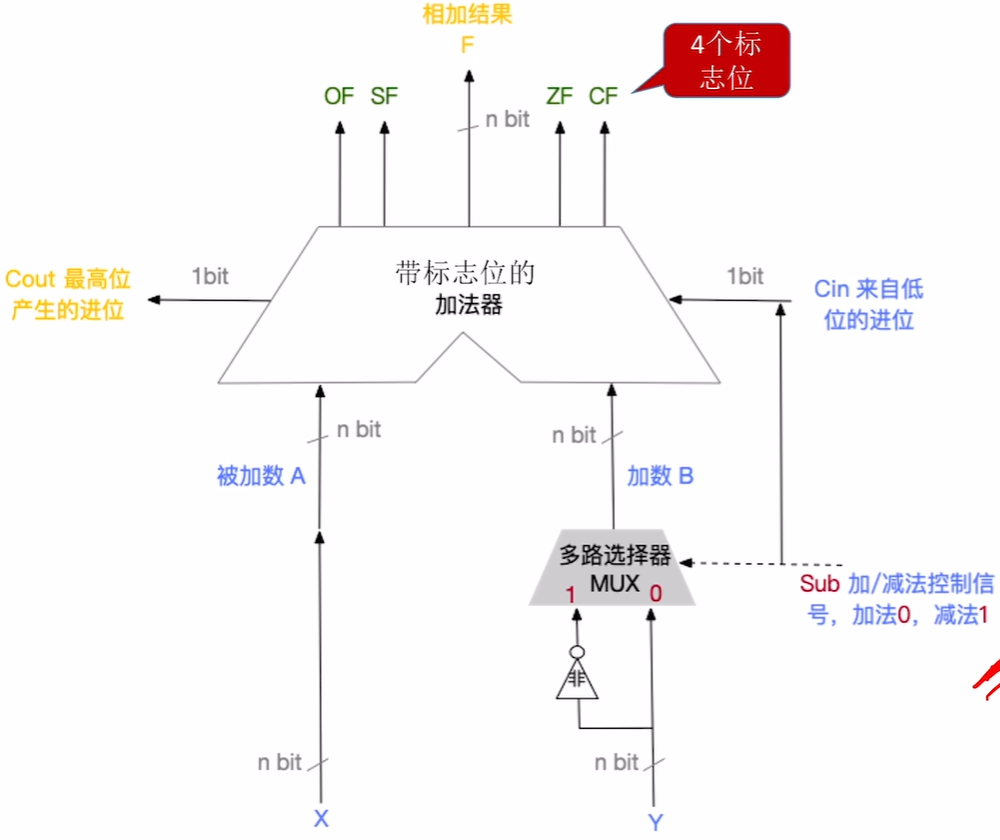
读图时抓住三个信号:
- 左输入 $X$ 直接进入加法器;
- 右输入 $Y$ 先经过多路选择器;
- 控制信号
Sub同时控制“是否取反”和“最低位进位”。
具体工作过程如下:
Sub |
第二操作数 | 最低位进位 $C_0$ | 加法器实际完成 |
|---|---|---|---|
| 0 | $Y$ | 0 | $F=X+Y$ |
| 1 | $\overline{Y}$ | 1 | $F=X+\overline{Y}+1=X-Y$ |
最低位进位 $C_0$ 就是图中右侧从 Sub 引来的一根控制线。做减法时如果没有把 $C_0$ 置 1,电路实际计算的是“反码相加”,结果会与补码差值相差 1。
8421 口诀:加法 0 与 0,减法 1 与 1。
Sub=0时第二操作数不取反、进位为 0;Sub=1时取反、进位为 1。
加法器输出的结果只保留低 $n$ 位,更高位的进位会单独成为 $C_{\text{out}}$。因此它天然服从 $2^n$ 取模运算:
$$F=(X\pm Y)\bmod 2^n$$
是否把这个结果解释为有效真值,要看后面四类标志位。
图中顶部的四个标志位分别回答四个不同问题:
| 标志 | 名称 | 由图中的哪个输出得到 | 含义 |
|---|---|---|---|
| ZF | 零标志 | 所有结果位都为 0 | 结果是否为 0 |
| SF | 符号标志 | 结果最高位 $F_{n-1}$ | 按补码解释时结果为正还是负 |
| CF | 进位/借位标志 | 最高位进位 $C_{\text{out}}$ 结合 Sub |
无符号数运算是否越界 |
| OF | 溢出标志 | 符号位进位与符号位输入进位 | 有符号补码运算是否越界 |
设最高位为第 $n-1$ 位:
- $C_n$ 表示加法器最终向外产生的进位,也就是图中的
Cout; - $C_{n-1}$ 表示由低一位送进符号位的进位,也就是“符号位下面的进位”;
- $F_{n-1}$ 是结果的最高位。
四个标志可写成:
$$ZF=1\iff F=000\cdots0$$
$$SF=F_{n-1}$$
$$OF=C_n\oplus C_{n-1}$$
$$CF= \begin{cases} C_n, & \text{加法 }(\mathrm{Sub}=0)\\[4pt] \overline{C_n}, & \text{减法 }(\mathrm{Sub}=1) \end{cases} $$
也可把 CF 合并写成
$$CF=C_n\oplus\mathrm{Sub}$$
CF 面向无符号数,表示加法有进位或减法不够减需要借位;OF 面向有符号补码,表示正负号组合已经超出当前位宽。
同一次运算完全可能“CF=1、OF=0”,也可能“CF=0、OF=1”。
补码溢出有三种等价判断法,分别适合不同题型:
| 方法 | 观察对象 | 判断规则 |
|---|---|---|
| 符号法 | 两个操作数和结果的符号 | 正 + 正得负,上溢;负 + 负得正,下溢 |
| 进位法 | 符号位进位 $C_{n-1}$ 与最终进位 $C_n$ | 两者不同则溢出:$V=C_n\oplus C_{n-1}$ |
| 双符号位法 | 两个符号位 $S_1S_2$ | 结果双符号位不同则溢出:$V=S_1\oplus S_2$ |
设 $A_s,B_s,F_s$ 分别是两个加数和结果的符号位,则单符号位法的逻辑表达式为
$$V=A_sB_s\overline{F_s} +\overline{A_s}\overline{B_s}F_s$$
其中 $V=1$ 表示溢出。第一项对应“负 + 负 = 正”,第二项对应“正 + 正 = 负”。
双符号位法可以先对操作数做符号扩展,使符号位变成两位,再参加运算:
- 正数变成
00...; - 负数变成
11...; - 结果的两个符号位相同 → 未溢出;
- 结果的两个符号位不同 → 溢出。
例如 4 位操作数扩展成 5 位双符号位:
  00111      7 + 1 = 8
+ 00001
-------
  01000
   ↑↑
   01:双符号位不同,发生上溢
自检:为什么同一组结果可能 CF=1、OF=0?
以 4 位运算为例子。
(1)1111 + 0001 = 0000
- 无符号数:$15+1=16$,超出 4 位无符号数范围,CF=1;
- 补码:$-1+1=0$,结果完全正确,OF=0;
- 结果最高位为 0,所以 SF=0、ZF=1。
(2)0111 + 0001 = 1000
- 无符号数:$7+1=8$,没有超过 4 位无符号数范围,CF=0;
- 补码:$7+1=8$ 已超出 $-8\sim7$,OF=1;
- 结果的符号位为 1,所以 SF=1,但零标志 ZF=0。
这两个例子说明:CF 与 OF 服务的是两套不同的数值解释。
加法器的速度瓶颈在于进位传递方式。
串行进位加法器把 $n$ 个全加器首尾相连,每一级的进位都等待前一级算完:
FA₀ ──C₁──> FA₁ ──C₂──> FA₂ ──> … ──Cₙ──> FAₙ₋₁结构简单、硬件少,但最坏情况下进位要从最低位一路传到最高位,延迟随位数近似线性增长。
并行进位加法器也称先行进位加法器。它增加专门的进位逻辑,使各高位进位不等前一级逐级算完,而是尽可能同时产生。
因此,并行进位的主要优点是缩短进位延迟,代价是门电路和连线更多、结构更复杂。408 中掌握这层区别即可,不需要展开具体进位公式。
参考来源
- 【408计算机组成原理强化(24版,23年录制)】 https://www.bilibili.com/video/BV1nr421n7qZ/?share_source=copy_web&vd_source=a677cb27fe552ba80620cd3e521c0e83
- 【BOK408计算机组成原理精讲课(25/26版,24年录制)】 https://www.bilibili.com/video/BV18TZuBQE5q/?share_source=copy_web&vd_source=a677cb27fe552ba80620cd3e521c0e83